 用大模型构建新人答疑机器人
这是整个 ACP 课程动手的第一篇,从最基础的 API 调用开始,一路推导到为什么需要 RAG。逻辑非常流畅,值得细看。
# 这篇讲什么
- 通过 OpenAI SDK 调用千问,理解 API 的基本用法(单轮、多轮、流式)
- 大模型的文本生成原理:Tokenization → Embedding → 推理 → 自回归
- temperature 和 top_p 参数的含义与调法
- 大模型无法回答私域问题的根本原因,以及 RAG 的引出逻辑
# 1. 通过 API 调用千问
我用阿里云 PAI-DSW 跑的代码,CPU 实例就够,新用户有 3 个月免费额度。
# 1.1 API Key 配置
不要把 Key 明文写进代码,容易泄露。课程提供了一个 load_key() 工具函数从配置文件读取,用这个更安全:
# 加载百炼的 API Key 用于调用千问大模型
import os, sys
os.chdir(os.path.join(os.path.dirname(os.path.abspath('')), 'course_core'))
sys.path.insert(0, os.getcwd())

from config.load_key import load_key
load_key()
print(f'''你配置的 API Key 是:{os.environ["DASHSCOPE_API_KEY"][:5]+"*"*5}''')
2
3
4
5
6
7
8
# 1.2 基础单轮对话
用 OpenAI SDK 调千问,base_url 换成百炼的兼容接口:
from openai import OpenAI
import os
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
def get_qwen_response(prompt):
    response = client.chat.completions.create(
        model="qwen-max",
        messages=[
            # system message 用于设置大模型的角色和任务
            {"role": "system", "content": "你负责教育内容开发公司的答疑,你的名字叫公司小蜜,你要回答同事们的问题。"},
            # user message 用于输入用户的问题
            {"role": "user", "content": prompt}
        ]
    )
    return response.choices[0].message.content
response = get_qwen_response("我们公司项目管理应该用什么工具")
print(response)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
运行后会发现模型给出的是通用建议(Jira、Trello),根本不知道这家公司用什么——这就是后面要解决的问题。
# 1.3 多轮对话
关键点:大模型 API 无状态,每次调用都是独立的。要实现"记得上文",必须把历史消息全部放进 messages 列表手动传入。
def multi_turn_chat():
    # 初始化对话历史,包含系统提示词
    conversation_history = [
        {"role": "system", "content": "你负责教育内容开发公司的答疑,你的名字叫公司小蜜,你要回答同事们的问题。"}
    ]

    # 模拟多轮对话
    user_questions = [
        "我们公司项目管理应该用什么工具?",
        "那我怎么申请这个工具的账号呢?",
        "申请一般需要多久能批下来?"
    ]

    for question in user_questions:
        print(f"👤 用户:{question}")

        # 将用户问题添加到对话历史
        conversation_history.append({"role": "user", "content": question})

        # 调用大模型,传入完整的对话历史
        response = client.chat.completions.create(
            model="qwen-max",
            messages=conversation_history  # 包含所有历史消息
        )

        # 获取模型回复
        assistant_message = response.choices[0].message.content
        print(f"🤖 小蜜:{assistant_message}\n")

        # 将模型回复也添加到对话历史,以便下一轮对话使用
        conversation_history.append({"role": "assistant", "content": assistant_message})

multi_turn_chat()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
对话轮次多了上下文就长,Token 消耗会增加,生产环境要做历史压缩或截断。
# 1.4 流式输出
加 stream=True,模型边生成边返回,用户体验好得多:
def get_qwen_stream_response(user_prompt, system_prompt):
    response = client.chat.completions.create(
        model="qwen-max",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        stream=True
    )
    for chunk in response:
        yield chunk.choices[0].delta.content

response = get_qwen_stream_response(user_prompt="我们公司项目管理应该用什么工具",system_prompt="你负责教育内容开发公司的答疑,你的名字叫公司小蜜,你要回答同事们的问题。")
for chunk in response:
    print(chunk, end="")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 2. 大模型是怎么工作的
# 2.1 文本生成流程
整个过程可以拆成 5 步,以输入 "ACP is a very" 为例:
第一步:文本分词(Tokenization)
计算机不能直接处理文字,先把文本切成 Token。Token 是子词片段,不等于完整的词。每个 Token 在词表里对应一个整数 ID。
第二步:Token 向量化(Embedding)
Token ID 本身没有语义,通过 Embedding 矩阵把每个 ID 映射成高维向量,同时加上位置编码,让模型知道每个词在句子里的位置。
第三步:大模型推理(前向传播)
向量序列穿过多层 Transformer 解码器,经过因果自注意力和前馈网络,最终得到最后一个 Token 的隐藏状态,再投影到词表维度,得到 Logits(每个候选 Token 的得分)。
第四步:解码与自回归
Logits 经过 softmax 得到概率分布,然后按照解码策略选出下一个 Token:
- 确定性解码:贪心解码(每次选最高概率)
- 随机采样:Top-p、Top-k
选出的 Token 追加到输入末尾,循环重复,直到生成 EOS 或达到最大长度——这就是自回归生成。
不同模型的终止符(EOS)不一样:
| 模型 | 终止符 |
|---|---|
| Qwen3 | <\|im_end\|> |
| GPT 系列 | <\|endoftext\|> |
| LLaMA/Mistral | </s> |
| DeepSeek V3 | <|end▁of▁sentence|> |
第五步:输出文本
把 Token ID 序列解码回字符串。流式输出就是每生成一个 Token 就立刻发给前端,所以有时会看到词被切开分段显示,这是正常现象。
# 2.2 temperature 和 top_p
这两个参数控制模型输出的随机性:
temperature:调整概率分布的"尖锐程度"
- 低温(如 0.1):概率集中,输出稳定,适合代码生成、信息提取
- 高温(如 1.5):概率分散,输出多样,适合创意写作
top_p:控制采样候选集合的范围
- 按概率从高到低累加,直到累计超过 top_p 阈值,从这个集合里随机选
- 值越小范围越窄,输出越固定
import time

def get_qwen_stream_response(user_prompt, system_prompt, temperature, top_p):
    response = client.chat.completions.create(
        model="qwen-max",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=temperature,
        top_p=top_p,
        stream=True
    )

    for chunk in response:
        yield chunk.choices[0].delta.content

# temperature,top_p的默认值使用Qwen-Max模型的默认值
def print_qwen_stream_response(user_prompt, system_prompt, temperature=0.7, top_p=0.8, iterations=10):
    for i in range(iterations):
        print(f"输出 {i + 1} : ", end="")
        ## 防止限流,添加延迟
        time.sleep(0.5)
        response = get_qwen_stream_response(user_prompt, system_prompt, temperature, top_p)
        output_content = ''
        for chunk in response:
            output_content += chunk
        print(output_content)

# 低温:输出稳定
print_qwen_stream_response(user_prompt="马也可以叫做", system_prompt="请帮我续写内容,字数要求是4个汉字以内。", temperature=0)

# 高温:输出多样
print_qwen_stream_response(user_prompt="马也可以叫做", system_prompt="请帮我续写内容,字数要求是4个汉字以内。", temperature=1.9)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
注意:不建议同时调 temperature 和 top_p,会导致输出不可预测。优先调其中一个。
即使把 temperature 设为 0、top_p 设极小值,同样输入也可能得到略有不同的结果——分布式推理系统本身有微小随机性,无法完全消除。
# 3. 大模型回答不了私域知识
# 3.1 直接"喂"知识的局限
最直接的想法:把公司文档放进 system prompt:
user_question = "我是软件一组的,请问项目管理应该用什么工具"

knowledge = """公司项目管理工具有两种选择:
  1. **Jira**:对于软件开发团队来说,Jira 是一个非常强大的工具...
  2. **Microsoft Project**:对于大型企业或复杂项目...
  在一般情况下请使用Microsoft Project,公司购买了完整的许可证。软件研发一组、三组和四组正在使用Jira,计划于2026年之前逐步切换至Microsoft Project。
"""

response = get_qwen_stream_response(
    user_prompt=user_question,
    system_prompt="你负责教育内容开发公司的答疑,你的名字叫公司小蜜,你要回答学员的问题。"+ knowledge,
    temperature=0.7,
    top_p=0.8
)

for chunk in response:
    print(chunk, end="")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
能回答了!但问题很快来了:整个公司知识库几百份文档,不可能全塞进去。
# 3.2 上下文窗口是瓶颈
大模型的输入容量(上下文窗口)是有限的,塞不下整个知识库。而且即使塞得下,也会有问题:
- 慢:上下文越长,推理时间越长
- 贵:按 Token 计费,冗长上下文成本高
- 干扰:无关信息多了反而影响回答质量
核心思路不是"塞多少",而是"塞得准不准"——这就是上下文工程(Context Engineering)。
# 3.3 上下文工程的核心技术
| 技术 | 作用 |
|---|---|
| RAG | 从外部知识库检索最相关的片段,精准填充上下文 |
| Prompt | 设计指令控制模型的思考方式和输出格式 |
| Tool | 让模型调用外部工具获取实时信息 |
| Memory | 为模型建立跨会话记忆 |
# 3.4 RAG 的原理
RAG 分两阶段:
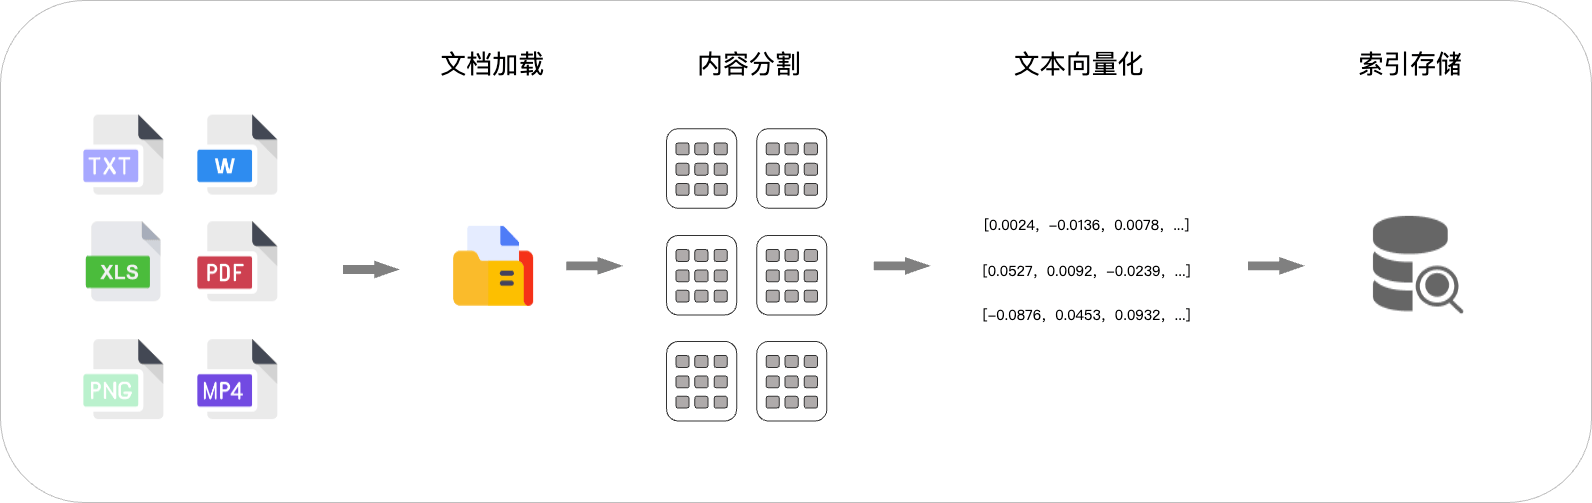
建立索引
把知识库文档 → 解析为文本 → 切成小段 → 用 Embedding 模型向量化 → 存入向量数据库。
检索与生成
用户提问 → 向量化问题 → 在向量库里找最相似的片段 → 把片段 + 问题一起送给大模型 → 生成回答。
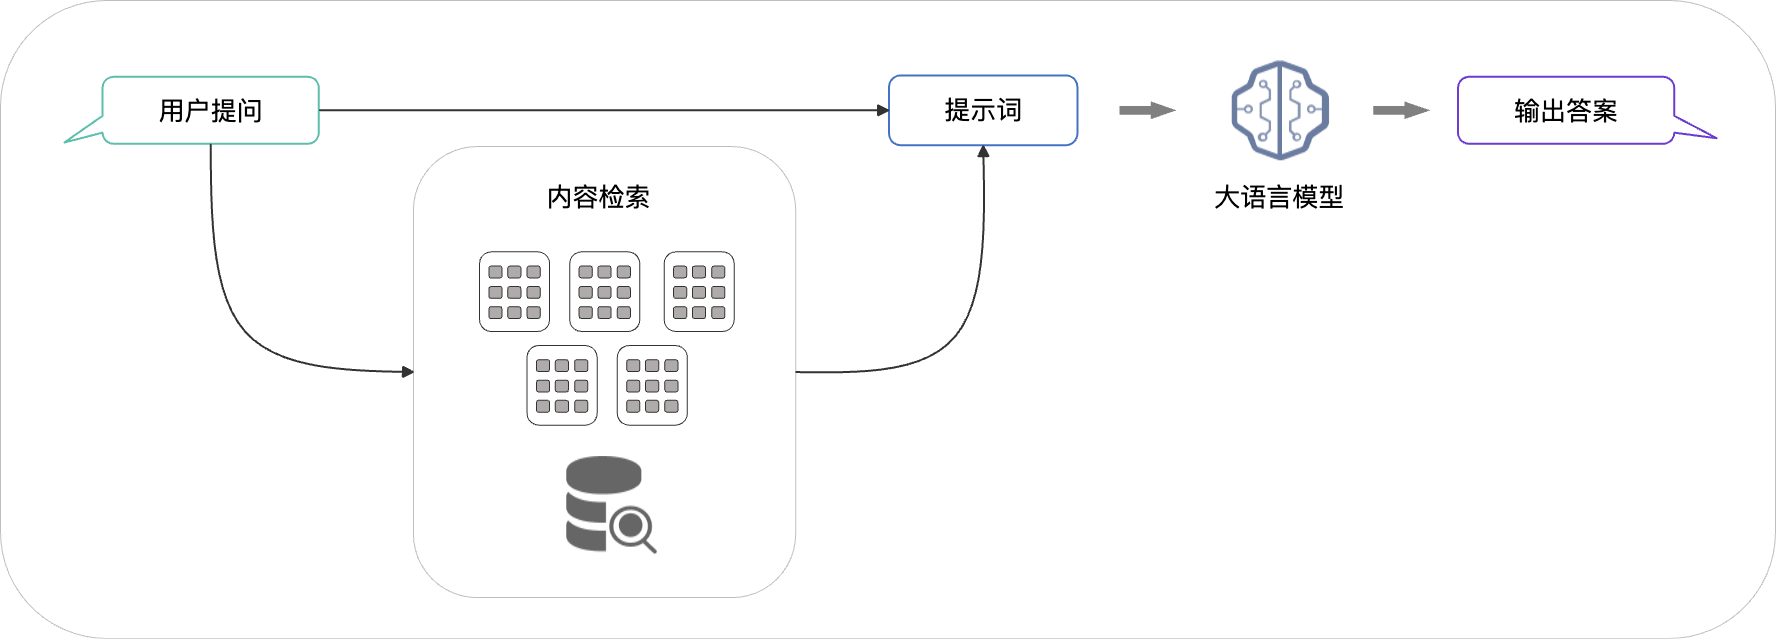
这样不用塞整个知识库,只塞最相关的几段,既准又省 Token。
# 个人总结
- 大模型 API 无状态这点最容易踩坑——不把历史消息传进去,模型根本"不记得"上一轮说了什么,多轮对话的历史管理是应用层的责任
- temperature 和 top_p 不要同时调,我试过,方向相反的参数叠加效果完全不可预期
- "上下文工程"这个概念抓住了大模型应用开发的核心:模型本身不差,差的往往是给它的信息质量
- RAG 的本质就是在"给模型看整本书"和"让模型蒙头乱猜"之间找到精准中间路线——检索相关段落,不检索不相关的
- 即使 temperature=0 也无法保证每次输出完全一致,分布式推理有内在随机性,这点要告知业务方