 扩展答疑机器人的知识范围
上一篇搞清楚了大模型的工作原理和局限性——它不知道公司内部的事情。这篇动手把 RAG 跑起来,让机器人真正能基于公司文档回答问题。
# 这篇讲什么
- RAG 的完整工作流:建立索引 + 检索生成,各步骤的作用
- 用 LlamaIndex 快速搭一个 RAG 应用
- RAG 多轮对话的坑(上下文丢失)和解法(问题改写)
# 1. RAG 的工作原理
RAG 类比开卷考试:大模型本身知识有限,但如果在它回答前把相关资料塞进上下文,回答质量就大幅提升了。RAG 的价值在于"精准检索"——不是全部给,而是找最相关的给。
# 1.1 建立索引(离线阶段)
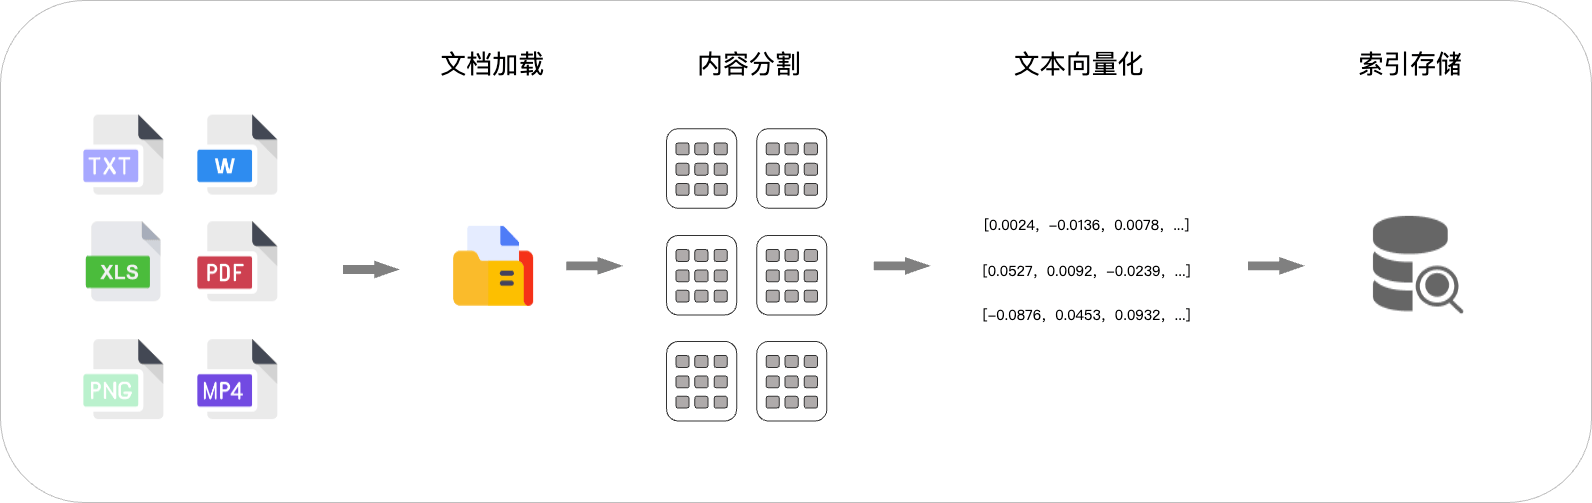
把文档处理成可检索的形式,分四步:
- 文档解析:把 PDF、Word 等格式解析成纯文本
- 文本分段:按段落/标题切成小块(chunk),方便精准检索
- 文本向量化:用 Embedding 模型把每个 chunk 转成高维向量,语义相近的向量距离近
- 存储索引:把向量存入向量数据库,后续直接查,不用每次重新建
# 1.2 检索生成(在线阶段)
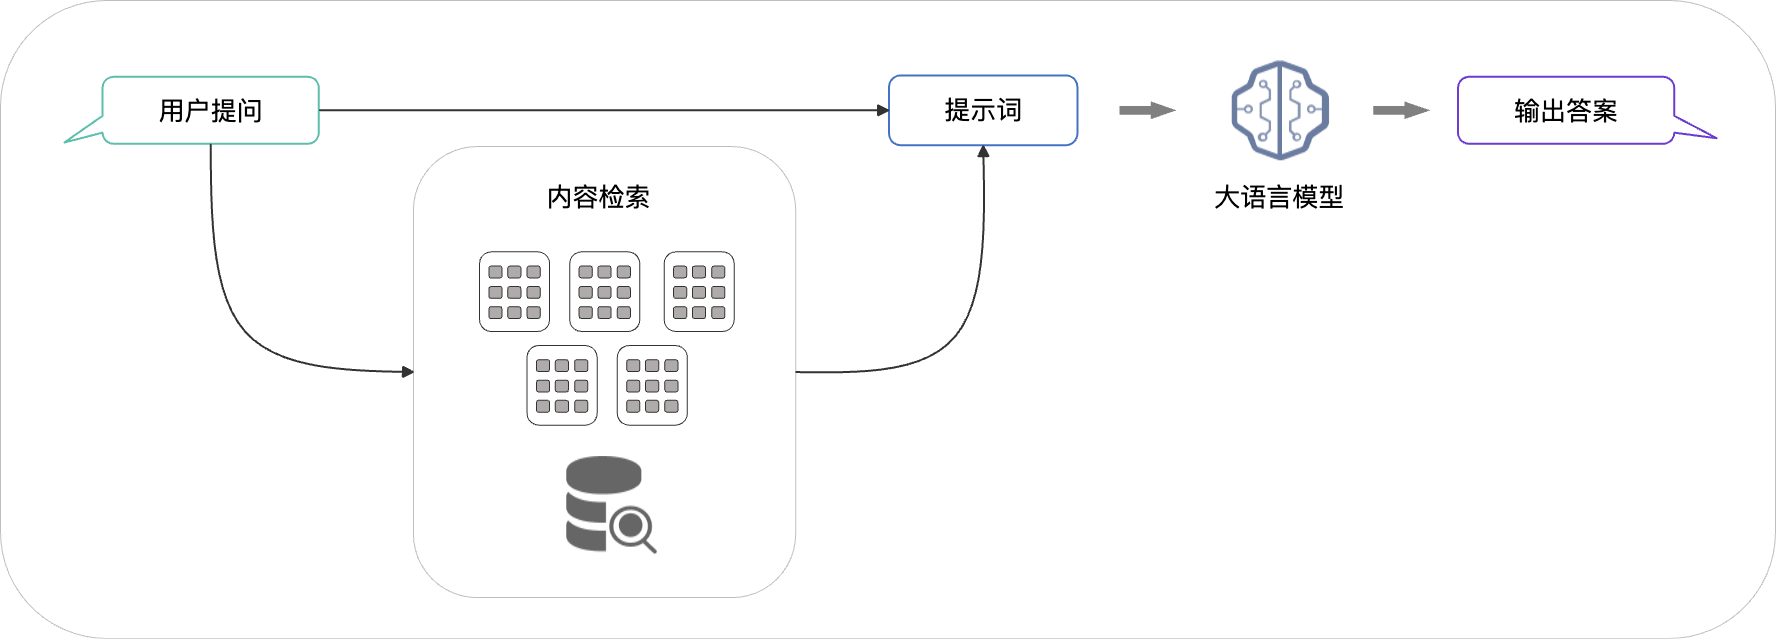
用户提问时:
- 检索:把问题也向量化,在向量库里找最相似的几个 chunk
- 生成:把这些 chunk + 用户问题组装成 prompt,让大模型生成回答
典型 prompt 模板:
请根据以下信息回答用户的问题:{召回文本段}。用户的问题是:{question}。
1
检索这步是 RAG 的核心,召回错了,后面生成再好也没用。后续的优化(rerank、句子窗口检索等)基本都是针对这步的。
# 2. 用 LlamaIndex 创建 RAG 应用
# 2.1 初始化环境
# 加载百炼的 API Key 用于调用千问大模型
import os, sys
os.chdir(os.path.join(os.path.dirname(os.path.abspath('')), 'course_core'))
sys.path.insert(0, os.getcwd())

from config.load_key import load_key, load_nltk
load_key()
# 生产环境中请勿将 API Key 输出到日志中,避免泄露
print(f'''你配置的 API Key 是:{os.environ["DASHSCOPE_API_KEY"][:5]+"*"*5}''')

load_nltk()
1
2
3
4
5
6
7
8
9
10
11
2
3
4
5
6
7
8
9
10
11
# 补充环境依赖
%pip install nbconvert
1
2
2
# 2.2 一行代码建索引、两行代码提问
LlamaIndex 把整个流程封装得很好,最简版只需要几行:
# 导入依赖
from llama_index.embeddings.dashscope import DashScopeEmbedding,DashScopeTextEmbeddingModels
from llama_index.core import SimpleDirectoryReader,VectorStoreIndex
from llama_index.llms.openai_like import OpenAILike

# 跳过NLTK下载,因为LlamaIndex默认使用NLTK进行文本预处理,但在某些环境中可能会因为网络问题导致下载失败,设置环境变量LLAMA_INDEX_DISABLE_NLTK为1可以禁用NLTK的使用。
import os
os.environ["LLAMA_INDEX_DISABLE_NLTK"] = "1"

# 这两行代码是用于消除 WARNING 警告信息,避免干扰阅读学习,生产环境中建议根据需要来设置日志级别
import logging
logging.basicConfig(level=logging.ERROR)

print("正在解析文件...")
# LlamaIndex提供了SimpleDirectoryReader方法,可以直接将指定文件夹中的文件加载为document对象,对应着解析过程
documents = SimpleDirectoryReader('./docs').load_data()

print("正在创建索引...")
# from_documents方法包含切片与建立索引步骤
index = VectorStoreIndex.from_documents(
    documents,
    # 指定embedding 模型
    embed_model=DashScopeEmbedding(
        # 你也可以使用阿里云提供的其它embedding模型:https://help.aliyun.com/zh/model-studio/getting-started/models#3383780daf8hw
        model_name=DashScopeTextEmbeddingModels.TEXT_EMBEDDING_V2
    ))
print("正在创建提问引擎...")
query_engine = index.as_query_engine(
    # 设置为流式输出
    streaming=True,
    # 此处使用qwen-plus模型,你也可以使用阿里云提供的其它qwen的文本生成模型:https://help.aliyun.com/zh/model-studio/getting-started/models#9f8890ce29g5u
    llm=OpenAILike(
        model="qwen-plus",
        api_base="https://dashscope.aliyuncs.com/compatible-mode/v1",
        api_key=os.getenv("DASHSCOPE_API_KEY"),
        is_chat_model=True
        ))
print("正在生成回复...")
streaming_response = query_engine.query('我们公司项目管理应该用什么工具')
print("回答是:")
# 采用流式输出
streaming_response.print_response_stream()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
建索引第一次比较慢(要调 Embedding API),之后可以保存到本地复用。
# 2.3 保存和加载索引
# 将索引保存为本地文件
index.storage_context.persist("knowledge_base/test")
print("索引文件保存到了knowledge_base/test")
1
2
3
2
3
# 将本地索引文件加载为索引
from llama_index.core import StorageContext,load_index_from_storage
storage_context = StorageContext.from_defaults(persist_dir="knowledge_base/test")
index = load_index_from_storage(storage_context,embed_model=DashScopeEmbedding(
        model_name=DashScopeTextEmbeddingModels.TEXT_EMBEDDING_V2
    ))
print("成功从knowledge_base/test路径加载索引")
1
2
3
4
5
6
7
2
3
4
5
6
7
加载后再测试一次:
print("正在创建提问引擎...")
query_engine = index.as_query_engine(
    # 设置为流式输出
    streaming=True,
    llm=OpenAILike(
        model="qwen-plus",
        api_base="https://dashscope.aliyuncs.com/compatible-mode/v1",
        api_key=os.getenv("DASHSCOPE_API_KEY"),
        is_chat_model=True
        ))
print("正在生成回复...")
streaming_response = query_engine.query('我们公司项目管理应该用什么工具')
print("回答是:")
streaming_response.print_response_stream()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
2
3
4
5
6
7
8
9
10
11
12
13
14
封装版(课程 chatbot 模块):
from chatbot import rag

# 引文在前面的步骤中已经建立了索引,因此这里可以直接加载索引。如果需要重建索引,可以增加一行代码:rag.indexing()
index = rag.load_index(persist_path='./knowledge_base/test')
query_engine = rag.create_query_engine(index=index)

rag.ask('我们公司项目管理应该用什么工具', query_engine=query_engine)
1
2
3
4
5
6
7
2
3
4
5
6
7
# 3. RAG 多轮对话的坑
# 3.1 问题所在
RAG 检索是拿当前这轮问题去向量库里查。如果用户第二轮问"他的主管是谁?",检索根本不知道"他"是谁,会召回错误内容。
# 3.2 解法:问题改写
用大模型把带上下文指代的问题改写成完整独立的问题,再去检索:
- 原问题:"他的主管是谁?"
- 改写后:"张三的主管是谁?"
from llama_index.core import PromptTemplate
from llama_index.core.llms import ChatMessage, MessageRole
from llama_index.core.chat_engine import CondenseQuestionChatEngine

# 定义问题改写的提示词模板
custom_prompt = PromptTemplate(
    """
    给定一段对话历史(人类与助手之间)和人类的后续问题,
    请将该问题改写为一个独立的问题,包含对话中所有相关的上下文信息。

    <对话历史>
    {chat_history}

    <后续问题>
    {question}

    <改写后的独立问题>
"""
)

# 模拟历史对话信息
custom_chat_history = [
    ChatMessage(role=MessageRole.USER, content="内容开发工程师有哪些细分类型?"),
    ChatMessage(role=MessageRole.ASSISTANT, content="内容开发工程师是综合性技术岗位。"),
]

# 创建查询引擎
query_engine = index.as_query_engine(
    streaming=True,
    llm=OpenAILike(
        model="qwen-plus",
        api_base="https://dashscope.aliyuncs.com/compatible-mode/v1",
        api_key=os.getenv("DASHSCOPE_API_KEY"),
        is_chat_model=True
    ))

# 创建支持多轮对话的聊天引擎
chat_engine = CondenseQuestionChatEngine.from_defaults(
    query_engine=query_engine,
    condense_question_prompt=custom_prompt,
    chat_history=custom_chat_history,
    llm=OpenAILike(
        model="qwen-plus",
        api_base="https://dashscope.aliyuncs.com/compatible-mode/v1",
        api_key=os.getenv("DASHSCOPE_API_KEY"),
        is_chat_model=True
    ),
    verbose=True  # 开启详细输出,可以看到改写后的问题
)

# 提问时只说「核心职责是什么」,不提及「内容开发工程师」
streaming_response = chat_engine.stream_chat("核心职责是什么?")
for token in streaming_response.response_gen:
    print(token, end="")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
verbose=True很有用,可以看到系统实际发出的改写后的问题,调试时能快速定位检索是否准确。
# 扩展:文本向量化原理
Embedding 模型通过对比学习训练:相关文本对的向量相似度高,不相关的相似度低。
- 建立索引时:把每个 chunk
[c1, c2, ..., cn]各自向量化存储 - 检索时:把用户问题
q向量化,找余弦相似度最高的 top-k 个向量对应的 chunk
这就是为什么 RAG 能理解语义相似但用词不同的问题——向量相近就能匹配,不依赖关键词完全一致。
# 个人总结
- LlamaIndex 封装得很好,几行代码就能搭起完整 RAG,适合快速验证,生产环境还需要考虑 chunk 策略、embedding 模型选择等细节
- 建索引比较慢(每个 chunk 都要调 Embedding API),一定要持久化保存,不然每次重启都要重建
- RAG 多轮对话的问题改写这个方案很优雅,本质上是在检索前先"翻译"一次,把指代词还原成具体实体
- 检索质量决定最终回答质量,后续的 rerank、chunk 大小调整都是在这个方向上优化
- 用语义向量检索代替关键词匹配,是 RAG 相比传统 FAQ 系统的核心优势所在
编辑 (opens new window)